AI」カテゴリーアーカイブ

UE5 Unreal Python を使った MCP のテスト

UE5 5.8 には MCP サーバー機能が搭載されましたが、もともと Unreal Engine には python コードをリモート実行する機能も備わっています。こちらでも似たようなことが可能で、5.8 よりも前のバージョンでも動きます。ただしサンドボックス化されていないため、もし AI エージェントから呼び出す場合は注意が必要となります。

Python Remote Execution の有効化

  1. もし有効になっていなかったらプラグインマネージャーから「Python Editor Script Plugin」を有効化して Editor を起動し直します
    • 大抵デフォルトで有効になっています
  2. メニューの “Edit” → “Project Settings…”
  3. 左側のカテゴリから「Python」を選択して、「Python Remote Execution」の中にある ” Enable Remote Execution? ” にチェックを入れます
  4. Editor を一旦閉じて起動し直します

MCP サーバー化スクリプトを作ってみる

python の remote 呼び出しを mcp 化します。ファイル名は “ue5-python-mcp.py” とします。

import os
import sys
import time

from mcp.server.fastmcp import FastMCP

ue5_root= os.environ.get('UE5_ENGINE_ROOT', 'C:/Program Files/Epic Games/UE_5.8')
sys.path.append( os.path.join( ue5_root, 'Engine/Plugins/Experimental/PythonScriptPlugin/Content/Python' ) )
from remote_execution import RemoteExecution

mcp= FastMCP('ue5-python', json_response=True)

#------------------------------------------------------------------------------

logger= None
def print_err( *msg ):
    if True:
        print( *msg, file=sys.stderr )
    else:
        global logger
        if not logger:
            logger= open( 'log.txt', 'w' )
        logger.write( ' '.join([ str(m) for m in msg]) + '\n' )
        logger.flush()


class UEInterface:
    def __init__( self ):
        self.remote_exec= None

    def find_node( self, nodes, machine ):
        for node in nodes:
            if machine == '*':
                return  node.get('node_id')
            pc= node.get('machine')
            if pc == machine:
                return  node.get('node_id')
        print_err( 'Error: UE5 node %s not found' % machine )
        return  None

    def connect( self ):
        if not self.remote_exec:
            self.remote_exec= RemoteExecution()
            self.remote_exec.start()
            time.sleep( 1 )
            hostname= os.environ.get('COMPUTERNAME',os.environ.get('HOST',os.environ.get('HOSTNAME','*')))
            node_id= self.find_node( self.remote_exec.remote_nodes, hostname )
            if node_id:
                self.remote_exec.open_command_connection( node_id )

    def disconnect( self ):
        if self.remote_exec:
            self.remote_exec.stop()
            self.remote_exec= None

    def script_wrapper( self, script ):
        out_str= 'try:\n'
        for line in script.split('\n'):
            out_str+= ' ' + line + '\n'
        out_str+= '\nexcept Exception as e:\n print("Error:",str(e))\n'
        return  out_str

    def exec( self, script ):
        wrapped= self.script_wrapper( script )
        result= self.remote_exec.run_command( wrapped )
        return  result

    def is_valid( self ):
        return  self.remote_exec

ueinterface= None

def get_api():
    global ueinterface
    if not ueinterface:
        ueinterface= UEInterface()
        ueinterface.connect()
    return  ueinterface

#------------------------------------------------------------------------------

@mcp.tool()
def run_ue5python( script:str ) -> str:
    """
    UE5 の remote_execution 機能を使って python script を実行します。
    UE5 の python api を呼び出すことが出来ます。

    Args:
        script     実行するpythonスクリプト
    """
    api= get_api()
    if not api.is_valid():
        return  'Error: Unable to connect to UE5'
    result= api.exec( script )
    success= result.get('success',False)
    output= result.get('output')
    return  str( { 'success': success, 'output': str(output) } )

#------------------------------------------------------------------------------

if __name__=='__main__':
    mcp.run(transport='stdio')

スクリプトをそのまま実行すると、エラー発生時にうまく動かなくなる場合があります。例外が出た場合、Editor のコンソール上では赤文字でエラーメッセージが表示されているのですが、戻り値として LLM には何も返っていないからです。原因がわからないとエラー時に無駄な試行錯誤を繰り返してしまうので、mcp に渡されたスクリプトコードをあらかじめ “try:” ~ “except” で囲んでエラーを返すようにしています。

AI クライアントアプリ側の MCP 設定例

使用するツールにあわせて設定してください。以下は uv を使う場合の mcp.json の設定例です。環境変数 UE5_ENGINE_ROOT にエンジンのパスを設定します。

  "mcpServers": {
    "ue5": {
      "command": "uv",
      "args": [
        "run",
        "--with",
        "mcp",
        "ue5-python-mcp.py"
      ],
      "env": {
        "UE5_ENGINE_ROOT": "C:/Program Files/Epic Games/UE_5.8"
      }
    }
  }

または直接 PYTHONPATH に UE5 の remote_execution.py が置いてあるパスを設定しても構いません。

  "mcpServers": {
    "ue5": {
      "command": "uv",
      "args": [
        "run",
        "--with",
        "mcp",
        "ue5-python-mcp.py"
      ],
      "env": {
        "PYTHONPATH": "C:/Program Files/Epic Games/UE_5.8/Engine/Plugins/Experimental/PythonScriptPlugin/Content/Python"
      }
    }
  }

uv を使わない場合は “pip3 install mcp” で mcp モジュールをあらかじめ追加しておいてください。

  "mcpServers": {
    "ue5": {
      "command": "python",
      "args": [
        "ue5-python-mcp.py"
      ],
      "env": {
        "UE5_ENGINE_ROOT": "C:/Program Files/Epic Games/UE_5.8"
      }
    }
  }

実行前の注意点

これはあくまで検証用で、サンドボックス化が行われていないので注意してください。このツールを使うと mcp 経由で任意の python コードが実行可能となります。ファイルアクセスやコマンド実行、ネットワークアクセス等が行われる可能性があるため、使用する場合は必ず安全対策を行ってください。以下はその例です。

  • ローカルアカウントを使ったまっさらな PC を用意して、そこで UE5 を起動する
  • 自動承認を行わず、呼び出されるスクリプトが問題ないか毎回確認してから手動承認する

使ってみる

先に UE5 Editor を起動してから、AI 側のクライアントアプリを起動します。例えば Claude Code のような mcp に対応したコーディングツールを使うことができます。Python の unreal モジュールの命令を AI 経由で実行できます。アセットの編集やレベルへの配置などもエージェントに任せることが可能です。

この方法を使うと 5.8 よりも古い UE5 でエージェントを使用することができます。ただ色々と機能制限はあります。UE5 5.8 の標準の MCP サーバーの方ができることが多く機能が豊富なので、やはり本格的に使う場合はそちらを使った方が良いかと思います。

関連ページ

UE5 5.8 の MCP サーバー機能を使用する

UE5 5.8 では実験機能として MCP サーバー機能が追加されました。Plugin として組み込まれており、設定で有効化することができます。MCP を使うとさまざまな AI 用クライアントと接続することが可能で、AI エージェントが直接 Unreal Engine を操作できるようになります。

UE5 5.8 Preview 版との違い

5.8 Preview 版エンジンでも MCP 機能はあったのですが、いくつか問題がありました。5.8 Release 版ではそのあたりが改善されているようです。なお UE5 5.8 Release 版付属であっても MCP 機能自体は実験機能扱いです。今後仕様が変わる可能性があります。

Preview 付属版では load_toolset 命令を使って必要な Tool だけ有効化していく仕組みでした。ただし load すると各 Tool が直接 Function Calling 用のテーブルに組み込まれるため、仮に全部ロードしてしまうと 700 以上もの関数がアクティブになります。そんな使い方はしないと思いますが、この場合 Tool の定義だけで Context Window のおよそ 150K ほどを占有する計算です。またクライアントアプリ次第ですが、ロードした Tool はそのセッションでは有効にならない可能性があります。

他にも関数名に本来使えないはずのドット ‘.’ が含まれていたり、関数名だけで 64 文字を超えるなど Tool の仕様に沿っていないので、使用する LLM の API によってはエラーになっていました。

Release 付属版では直接 Tool として関数を公開せずに、call_tool 命令を使って間接的に呼び出す仕組みに変更されています。LLM に直接公開される関数は 3つだけです。

  • list_toolsets
  • describe_toolset
  • call_tool

list_toolsets, describe_toolset を使って存在する命令の使い方を調べつつ、call_tool に独自の “命令名” とパラメータを渡して実際の呼び出しを行うわけです。間接的にはなりますが、API 側の Tool とは別のネームスペースなるので関数名の制約を受けなくなります。また Tool 定義だけで Context Window を大量に消費することもなくなり効率化されます。

ちなみに Release 付属版でも Editor Preferences → “Model Context Protocol” の “Enable Tool Search” を false にすると Tool として全部ロードされるので注意してください。

他にも Preview だと Python script で例外などのエラーが呼び出し元に返っておらず、何が原因でエラーになったのか AI 側で判断できずにはまってしまうことがありました。Release 付属版ではそういった問題も解消されているようです。

MCP 機能を有効化する

以下何らかのサンプルプロジェクトを作成して Editor が開いてる状態を想定しています。

(1) Editor の言語を英語にします (重要)

  1. メニューの「編集」→「エディタの環境設定」→左側一般の中にある「地域&言語」
  2. 「エディタの言語」を “日本語” から “英語” に変更
  3. Unreal Editor を一旦閉じて起動し直す

日本語設定のままだと、Blueprint (BP) のノード名やピン名が日本語のまま AI に渡されます。この場合 AI が混乱してしまうようで、うまく BP ノードの編集ができないことがあります。英語に切り替えておくことをお勧めします。

(2) プラグインを有効化します

  1. メニューの「Edit」→「Plugins」
  2. 一番上の検索欄に「mcp」を入力
  3. 候補に出てきた「Unreal MCP」にチェックを入れる
    • “MCP Client Toolset” の方は不要です
  4. 同じように検索欄で「toolset」を入力
    • ここに出てきた候補が MCP 用の命令郡になります
  5. 候補に出てきた「Editor Toolset」にチェックを入れる
    • 他にも必要なものがあればチェックを入れます
    • ちなみに “All Toolset” にチェックを入れると、大半のツールが自動的に有効になります
  6. Unreal Editor を起動し直す

あまり多くのツールを有効化してしまうと効率が悪くなるので、最初は最小限にしておくことをお勧めします。

(3) MCP サーバーを起動します

  1. メニューの「Edit」→「Editor Preferences…」→ 左側 General の中にある「Model Context Protocol」
  2. 「Auto Start Server」にチェックを入れておく
    • 注意: “Enable Tool Search” には必ずチェックを入れた状態にしてください
  3. Unreal Editor を起動し直す

Editor を起動し直す代わりにコンソールコマンド「ModelContextProtocol.StartServer」を実行しても構いません。

クライアント (AI エージェント) から接続する

Claude Code や Codex 等、各種ツールに合わせて設定します。設定方法はクライアントアプリごとに異なるのでそちらに従ってください。

設定ファイルの自動生成を使う場合

メジャーなツールに関しては自動的に設定ファイルを生成する機能があるようです。コンソールコマンドで「ModelContextProtocol.GenerateClientConfig All」を実行すると、プロジェクトフォルダに “.mcp.json” 等の設定ファイルが作られます。詳しくはドキュメントを参照してください。

手動で設定する場合

mcp.json 等への設定例は以下のとおりです。

{
  "mcpServers": {
    "ue5": {
      "type": "http",
      "url": "http://127.0.0.1:8000/mcp"
    }
  }
}

Streamable HTTP に対応していないクライアントの場合は以下のような設定が必要かもしれません。

{
  "mcpServers": {
    "ue5": {
      "command": "cmd",
      "args": [
        "/c",
        "npx",
        "-y",
        "mcp-remote",
        "http://127.0.0.1:8000/mcp"
      ]
    }
  }
}

接続確認

先に UE5 Unreal Editor を起動した状態にしてから、コーディング AI エージェント (MCP クライアント) を立ち上げます。「UE5の現在のレベル名は?」など簡単な質問をしてみてください。

使ってみる

MCP で UE5 に接続した AI エージェントから指示を出すと人間の代わりに操作してくれます。Actor の作成や BP の編集もできますが結構時間がかかります。学習による事前知識ゼロなので、説明を見てひとつひとつ確認しながらノードやピンを繋いで構築していく感じです。DSL を使ってまとめて BP コードを編集することもできますが、エラーを出しながら AI もだいぶ試行錯誤しているようです。

UE5 5.8 で ThirdPersonTemplate (C++) のサンプルプロジェクトを作成し、簡単な BP 処理を実装してもらいました。

「Pキーでキャラクタから前方に球を発射するようにして。球は物理で転がるようにしたい」

マテリアルを割り当てたり調整もしてもらいました。

使用したコーディングエージェントは自作のもので、ローカル LLM を使っています。使ったモデルは Qwen3.6 27b (MTP) です。Context Window の消費量は 90~100K になりました。GPU は Radeon AI PRO R9700 32GB で、10分ほどかかっています。

CPURyzen 7 9700X
RAMDDR5-5600 128GB
GPURadeon AI PRO R9700 32GB
ModelQwen3.6 27b MTP (UD-Q4_K_XL)
AI Agent自作

他のモデルでも試してみました。

Qwen3.5 系 (Qwen3.5 27b / 122b-a10b) は一発で実装できず何度かやり取りが必要で、かつ手動での作業を求めてきました。

ローカルではなく Cloud のオープンモデルですが、DeepSeek-V4 Flash や GLM-5.2 はきちんと動作するものができました。

逆に Cloud の Gemma 4 31b (gemma4:31b-cloud) は途中で停止し、何度か継続したもののうまく実装できませんでした。ローカルでの Gemma 4 は未確認です。

Python とサンドボックス

各 Tool は直接呼び出すだけでなく、python スクリプトを使うことができます。繰り返し処理などは python を使ってくれるので効率が上がります。ただし使用できる命令は基本的に Toolset で有効にしたものと同じです。直接 UE5 の Python API (unreal module) を使うことはできず、また多くの外部モジュールは使用禁止となっています。これはサンドボックス化のためです。

クライアントの AI エージェント側をサンドボックス化したり情報へのアクセスを制限したとしても、mcp 経由で任意の python code を実行できると制限の意味がなくなってしまいます。python の標準の機能を使えばほぼ制限無くなんでもできるからです。よって安全のために Python の実行は多くの機能が制限されており、サンドボックス化されています。

BP の DSL 編集機能

BP の編集は Tool を使ってノードのピンをつなぎ、直接グラフを構築していくことができます。ただし大きなグラフの構築だと効率が悪いので、BP 自体をまとめてテキストで編集する機能があります。

  • read_graph_dsl
  • write_graph_dsl

試しに ThirdPersonTemplate (BP) の BP_ThirdPersonCharacter から EventGraph を取得してみるとこんな感じになりました。Lisp 風の表現となっています。

(event EnhancedInputActionIA_Move (ActionValue_X ActionValue_Y ElapsedSeconds TriggeredSeconds InputAction))

(event EnhancedInputActionIA_Look (ActionValue_X ActionValue_Y ElapsedSeconds TriggeredSeconds InputAction))

(event Touch|EventPrimaryThumbstick (Axis_X Axis_Y)
  (CallFunction|Move Axis_X Axis_Y))

(event Touch|EventSecondaryThumbstick (Axis_X Axis_Y)
  (CallFunction|Aim Axis_X Axis_Y))

(event EnhancedInputActionIA_MouseLook (ActionValue_X ActionValue_Y ElapsedSeconds TriggeredSeconds InputAction))

(event EnhancedInputActionIA_Jump (ActionValue ElapsedSeconds TriggeredSeconds InputAction))

(event Touch|EventTouchJumpStart
  (Character|Jump))

(event Touch|EventTouchJumpEnd
  (Character|StopJumping))

Move 関数はこのように定義されています。

(fn Move (X Axis Y Axis)
  (Pawn|Input|AddMovementInput
    (Math|Vector|GetRightVector (Pawn|GetControlRotation) 0.0 (Pawn|GetControlRotation)) X Axis)
  (Pawn|Input|AddMovementInput
    (Math|Vector|GetForwardVector 0.0 0.0 (Pawn|GetControlRotation)) Y Axis))

複雑な BP の構築でも、大量の Tool Call を使って力技で作っているわけではないことがわかります。

使ってみて

BP 編集は使い方を確認したり、試行錯誤がある分だけ時間がかかってトークンも消費します。知識にある汎用言語を使ってコード生成するのと比べると、どうしても効率は落ちていると思います。できるだけ性能が高いモデルを使った方が良いのかもしれません。BP ではなく C++ と Live Coding Toolset を使う方法もありますが、コードに問題があるとすぐ Editor が落ちますので今のところはどちらが良いとも言えません。UE6 でテキスト言語に回帰する理由もわかる気がします。もちろんまだ登場したばかりの新機能なので、今後改良が進んで使いやすくなっていくものと思われます。

関連ページ

Local LLM の推論速度

Local LLM は使用するソフトによって動作速度が変わります。前回紹介したモデルがどれくらいの速度で動くのか、いろいろな環境で比較してみました。

Qwen3.5 122B-A10B : Ryzen 5700X DDR4 + RTX 5060Ti 16GB

  • モデル Qwen3.5 122B-A10B Q4_K_M、Qwen3.5 122B-A10B UD-Q4_K_M MTP
  • Ryzen 7 5700X DDR4-3200 96GB + GeForce RTX 5060Ti 16GB、Windows 11、CUDA

Qwen3.5 122B-A10B を Ryzen 7 5700X DDR4-3200 と GeForce RTX 5060Ti 16GB で走らせた場合の速度比較です。ctx size は以降すべて 8192 です。

ModelCPU + GPUソフトウエア設定速度 (大きい方が高速)
Qwen3.5 122B5700X + 5060TiOllama 0.24.0デフォルト3.28 tps
Qwen3.5 122B5700X + 5060TiOllama 0.30.8デフォルト13.34 tps
Qwen3.5 122B5700X + 5060TiLMStudio 0.4.16デフォルト5.69 tps
Qwen3.5 122B5700X + 5060TiLMStudio 0.4.16GPU=48, CPU=4214.01 tps
Qwen3.5 122B5700X + 5060Tillama.cpp b9631デフォルト13.97 tps

Ollama は v0.24 までは非常に遅くお勧めできなかったのですが、最近リリースされた 0.30 から llama.cpp ベースになったようで、速度が改善されています。

LMStudio はデフォルトだとあまり速くありません。環境に合わせて設定すればきちんと速度が出ます。GPU は「GPU Offload」の値、CPU は「Nubmer of layers for which to force MoE layers into CPU」の値です。

llama.cpp は最新版を使っておけば、デフォルトのままで速いので簡単です。

MTP だとさらに速くなりますが、CPU 併用の MoE だとそこまで大きな差が出ません。以下の例だと MTP で +13% ほど速くなっています。

ModelCPU + GPUソフトウエア設定速度 (大きい方が高速)
Qwen3.5 122B UD MTP5700X + 5060TiLMStudio 0.4.16デフォルト5.22 tps
Qwen3.5 122B UD MTP5700X + 5060TiLMStudio 0.4.16GPU=49, CPU=4514.34 tps
Qwen3.5 122B UD5700X + 5060TiLMStudio 0.4.16CPU=49, CPU=4512.50 tps
Qwen3.5 122B UD5700X + 5060TiLMStudio 0.4.16CPU=49, CPU=4412.66 tps

Qwen3.5 122B-A10B : Core i7-13700 DDR5 + RTX 4060Ti 16GB

  • Qwen3.5 122B-A10B Q4_K_M 、 Qwen3.5 122B-A10B UD-Q4_K_M MTP
  • Core i7-13700 DDR5-5600 96GB + GeForce RTX 4060Ti 16GB、Linux、CUDA

別のマシン (Linux) での比較です。やはり Ollama は 0.24 以前と 0.30 以後では別物です。それでも結果を見ると llama.cpp をそのまま使用した方が速度が速く効率が良さそうです。

ModelCPU + GPUソフトウエア設定速度 (大きい方が高速)
Qwen3.5 122B13700 + 4060TiOllama 0.24.0デフォルト5.18 tps
Qwen3.5 122B13700 + 4060TiOllama 0.30.9デフォルト13.71 tps
Qwen3.5 122B13700 + 4060Tillama.cpp b9672デフォルト18.94 tps
Qwen3.5 122B UD MTP13700 + 4060Tillama.cpp b9672–spec-type draft-mtp
–spec-draft-n-max 2
19.22 tps

Qwen3.6 27B : Ryzen 7 9700X DDR5 + Radeon R9700 32GB

  • モデル Qwen3.6 27B Q4_K_M 、 Qwen3.6 27B UD-Q4_K_M MTP
  • Ryzen 7 9700X DDR5-5600 128GB + Radeon AI PRO R9700 32GB、Windows 11、Vulkan

以下は更に別マシンでの比較です。Qwen3.6 27B は 122B-A10B よりもパラメータは少ないですが Dense なので 122B-A10B よりも演算負荷は高くなっています。

VRAM が 32GB あるためパラメータが全部 VRAM に全部乗っています。この場合調節とか不要なので簡単です。また MTP の効果も高く、生成は 40~60% くらい速くなっています。MTP の結果は結構ばらつきがあるので注意。

ModelCPU + GPUソフトウエア設定速度 (大きい方が高速)
Qwen3.6 27B9700X + R9700Ollama 0.24.0デフォルト2.40 tps
Qwen3.6 27B9700X + R9700Ollama 0.30.9デフォルト28.21 tps
Qwen3.6 27B9700X + R9700LMStudio 0.4.16デフォルト33.10 tps
Qwen3.6 27B UD MTP9700X + R9700LMStudio 0.4.16デフォルト52.73 tps
Qwen3.6 27B9700X + R9700llama.cpp b9670デフォルト33.32 tps
Qwen3.6 27B UD MTP9700X + R9700llama.cpp b9670–spec-type draft-mtp
–spec-draft-n-max 2
54.00 tps

Ollama 0.24 の速度が極端に遅いですが、GPU を認識できておらず CPU だけで動いていました。0.30 では GPU が使われるようになっています。

Gemma 4 31B : Ryzen 7 9700X DDR5 + Radeon R9700 32GB

  • モデル Gemma 4 31B QAT
  • Ryzen 7 9700X DDR5-5600 128GB + Radeon AI PRO R9700 32GB、Windows 11、Vulkan

Gemma 4 31b も 32GB あればそこそこ大きな ctx で VRAM に載ります。

ModelCPU + GPUソフトウエア設定速度 (大きい方が高速)
Gemma 4 31B QAT9700X + R9700LMStudio 0.4.16デフォルト29.69 tps
Gemma 4 31B QAT9700X + R9700llama.cpp b9670デフォルト30.13 tps

Qwen3.5 122B-A10B : EVO-X2 128GB Ryzen AI MAX+ 395

  • モデル Qwen3.5 122B-A10B Q4_K_M 、 Qwen3.5 122B-A10B UD-Q4_K_M MTP
  • EVO-X2 128GB Ryzen AI Max+ 395 + Radeon 8060S、Windows 11、Vulkan

比較的速いメモリが 128GB あるため大きなモデルも動きますが、専用 VRAM を使った GPU よりは低速です。VRAM には 96GB 割り当てています。mmap の無効化が必要です。

ModelCPU + GPUソフトウエア設定速度 (大きい方が高速)
Qwen3.5 122BRyzen AI MAX+395Ollama 0.24.0OLLAMA_NO_MMAP=18.73 tps
Qwen3.5 122BRyzen AI MAX+395Ollama 0.30.9OLLAMA_NO_MMAP=125.49 tps
Qwen3.5 122BRyzen AI MAX+395LMStudio 0.4.16Try mmap()=off28.78 tps
Qwen3.5 122B UD MTPRyzen AI MAX+395LMStudio 0.4.16Try mmap()=off32.45 tps
Qwen3.5 122BRyzen AI MAX+395llama.cpp b9670–no-mmap29.86 tps
Qwen3.5 122B UD MTPRyzen AI MAX+395llama.cpp b9670–no-mmap
–spec-type draft-mtp
–spec-draft-n-max 2
33.34 tps

Radeon AI PRO R9700 (RDNA4) と違ってこちらは Ollama 0.24 でも GPU (RDNA3.5) を認識していますが、なぜか VRAM 割り当てを間違えます。VRAM に余裕があるのに CPU に 33% 割り当てられてしまい速度が落ちています。0.30 ではこの問題も直っており、GPU 100% になりました。

エージェントで使う場合

エージェントで利用する場合は大きな Context Windows が必要なので 64K 以上に設定することになります。その分メモリが必要で、今回の結果よりも速度は遅くなります。またエージェントでは入力プロンプトも大きく Prefill でかなり時間がかかります。EVO-X2 は 122B など大きなモデルも動きますが Prefill 自体はあまり速くないので、ローカル LLM の場合できるだけ KV キャッシュを壊さないような使い方が必要になります。

Ollama は速度が遅く VRAM の容量割り振りなど問題があったのですが、先日リリースされた 0.30 で改善されているようです。ただローカルで動かす場合、他のソフトが使えるなら他のソフトを使った方が良さそうです。(Ollama Cloud はよく使っています)

関連ページ

普段よく使ってる Local LLM のオープンモデル

普段よく Local LLM としてローカルマシン上で使っているモデルは黄色いエリアのものです。

各グループ毎に上が上位モデルで下が下位モデルになっています。エージェント用でお勧めのものは青線より上です。

個人向けの一般 PC (RAM 64GB 以下&VRAM 16GB 以下) で快適に動くのは残念ながら青線よりも下の緑色のあたりになります。黄色のモデルを走らせる場合は、メモリや VRAM の大きい高性能な PC が必要です。

OpenClaw を複数台の PC を使って 122b の Local LLM だけで運用する

複数台の PC を使って OpenClaw を使用しています。OpenClaw は多くのトークンを消費しますので、クラウドの API を使わずに自分の PC だけで運用できないかいろいろ試しています。

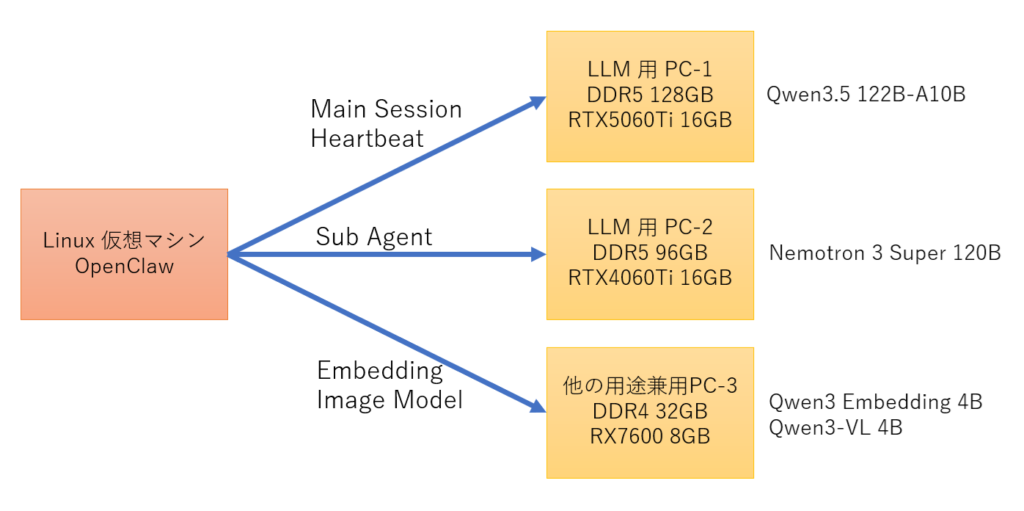
現在は以下の図のように 120b クラスのモデルを使用しています。AI 用の特別なマシンではなく、(メモリ増設した) 汎用の PC です。

本来なら LLM 用の PC は 1台だけでも動作できるのですが、複数台に分けているのは理由があります。PC-3 は空いてる PC の VRAM を間借りすることが目的です。PC-2 を用意したのは Sub Agent をバックグラウンドで並列動作させられることと、Main セッションの KV キャッシュとの分離のためです。

もし使える PC 台数に余裕があるなら、だいぶ贅沢ですが Heartbeat 用 PC も分けることができます。

一般向け PC での生成速度

前回説明したように、普通の PC でもメモリさえあれば 100b 以上のモデルも動くようになってきました。生成速度は 10~20 token/s ほどなので、AI 専用のマシンやクラウドの API と比べると非常に低速です。

それでも Slack のようにストリーミング表示してくれるクライアントで使っていると、思ったよりもずっと早くレスポンスが返ってくることがわかります。生成速度が遅くても使えているのは KV キャッシュが再利用できているおかげです。

逆にキャッシュが効かないケースでは一度のやりとりでも 5~10分ほど待たされるので、これが非常に重要であることがわかります。

Sub Agent を別の PC に割り当てる

OpenClaw は大きなコンテキストサイズを必要としますが、コンテキストウィンドウ長を増やすとその分生成速度は落ちていきます。VRAM 16GB でバランスを取るとだいたい 64K くらいがちょうどよいかと思います。

OpenClaw はコンパクション後でもトークン数は 20K 以上あり、使っていると簡単に 50K を超えます。そのため Main セッションの場合は、コンテキストウィンドウはほぼ単一のスロットです。この状態で Sub Agent などの別のセッションが走ると KV キャッシュが上書きされてしまい、再び長い再生成 (Prefill) 待ちになってしまうことがあります。

そこで Sub Agent に使う LLM 用の PC を別に用意すれば、長いコンテキストでのキャッシュ領域の衝突を避けることができます。.openclaw/openclaw.json の設定だと以下のようになります。

{
  "agents": {
    "defaults": {
      "model": {
        "primary": "llamacpp-pc1/Qwen3.5-122B-A10B"                 Main モデル
      },
      "subagents": {
        "model": "llamacpp-pc2/NVIDIA-Nemotron-3-Super-120B-A12B",  Sub Agent 
        "maxConcurrent": 1
      },
      "maxConcurrent": 2,
      "timeoutSeconds": 1800,
      "llm": {
        "idleTimeoutSeconds": 1800
      },
      
    }
  },
  "models": {
    "providers": {
      "llamacpp-pc1": {
        "api": "openai-completions",
        "apiKey": "llama.cpp",
        "baseUrl": "http://192.168.0.101:8080/v1",     Main  LLM PC  URL
        "models": [
          {
            "contextWindow": 65536,
            "cost": { "cacheRead": 0, "cacheWrite": 0, "input": 0, "output": 0 },
            "id": "Qwen3.5-122B-A10B",
            "input": [ "text", "image" ],
            "maxTokens": 32768,
            "name": "Qwen3.5-122B-A10B",
            "reasoning": true
          }
        ]
      },
      "llamacpp-pc2": {
        "api": "openai-completions",
        "apiKey": "llama.cpp",
        "baseUrl": "http://192.168.0.102:8080/v1",     Sub Agent  LLM PC  URL
        "models": [
          {
            "contextWindow": 65536,
            "cost": { "cacheRead": 0, "cacheWrite": 0, "input": 0, "output": 0 },
            "id": "NVIDIA-Nemotron-3-Super-120B-A12B",
            "input": [ "text" ],
            "maxTokens": 32768,
            "name": "NVIDIA-Nemotron-3-Super-120B-A12B",
            "reasoning": true
          }
        ]
      }
    }
  },
  
}

また PC を分けたことで、Sub Agent を完全にバックグラウンドで並列に走らせられるようになります。

なお Heartbeat は Main と同じコンテキストを共有しますが、同じスロットが割り当てられるので実行するタスクによっては競合する可能性があります。もし Heartbeat に使う LLM 用 PC も別に用意する場合は以下のように設定します。

{
  "agents": {
    "defaults": {
      "model": {
        "primary": "llamacpp-pc1/Qwen3.5-122B-A10B"                 Main モデル
      },
      "subagents": {
        "model": "llamacpp-pc2/NVIDIA-Nemotron-3-Super-120B-A12B",  Sub Agent 
        "maxConcurrent": 1
      },
      "heartbeat": {
        "model": "llamacpp-pc4/Qwen3.5-122B-A10B"                   Heartbeat 
      },
      "maxConcurrent": 2,
      "timeoutSeconds": 1800,
      "llm": {
        "idleTimeoutSeconds": 1800
      },
      
    }
  },
  
}

注意点

OpenClaw 用に Mac 上で LMStudio を使う場合は GGUF の方をお勧めします。単純な生成速度なら MLX の方が速いのですが、MLX ではキャッシュが再利用されずに毎回 Prefill が走ってしまうようです。

LLM 用 PC 側での実行例

LLM 用 PC では llama.cpp を使っています。以下はその実行例です。

llama-server.exe --model Qwen3.5-122B-A10B-Q4_K_M-00001-of-00002.gguf --mmproj mmproj-Qwen3.5-122B-A10B-BF16.gguf --alias Qwen3.5-122B-A10B -t 8 --ctx-size 65536 --host 0.0.0.0 --port 8080 --temp 0.6 --min-p 0.0 --top-p 0.95 --top-k 20 -fa on
llama-server --model NVIDIA-Nemotron-3-Super-120B-A12B-Q4_K_M-00001-of-00003.gguf --alias NVIDIA-Nemotron-3-Super-120B-A12B -t 8 --ctx-size 65536 --temp 0.6 --min-p 0.0 --top-p 0.95 --host 0.0.0.0 --port 8080 -fa on

複数の Sub Agent を同時実行するには

subagents.maxConcurrent = 1 を指定していますが、複数の Sub Agent を実行することは可能です。ただし並列度は 1になるので、Agent の数だけ時間がかかることになります。

もし実行時間短縮のために並列に走らせたい場合は、Sub Agent 用に更に追加の PC を割り当てる必要があります。直接コマンドから spawn 起動する場合は個別にモデル指定ができますが、設定ファイルの openclaw.json には Agent 毎に一つの Sub Agent モデルしか記述しておくことができないようです。

複数台の PC を使った並列化を行いたい場合は、個別にコマンドから model 指定で spawn するか、もしくは別の Coding Agent を利用する方法があります。例えば OpenClaw から Codex CLI の呼び出しができるので、Codex 側の設定で別の PC の Local LLM を割り当てておけば以下の 3つで並列実行になります。

  • Main Session / Heartbeat
  • Sub Agent
  • Codex CLI

画像認識モデルの指定

クラウドの商用モデルと違い、Local LLM が使うオープンモデルは画像認識に対応していないことがあります。Qwen3.5 の場合は画像入力に対応しているので不要ですが、他のモデルを使うときは以下のように VLM モデルを指定することができます。ここでは更に別の PC を割り当てています。

{
  "agents": {
    "defaults": {
      "model": {
        "primary": "llamacpp-pc1/NVIDIA-Nemotron-3-Super-120B-A12B"  Main モデル
      },
      "imageModel": {
        "primary": "lmstudio-pc3/qwen/qwen3-vl-4b"                  画像認識 
      },
      "subagents": {
        "model": "llamacpp-pc2/NVIDIA-Nemotron-3-Super-120B-A12B",  Sub Agent 
        "maxConcurrent": 1
      },
      "maxConcurrent": 2,
      "timeoutSeconds": 1800,
      "llm": {
        "idleTimeoutSeconds": 1800
      },
      
    }
  },
  "models": {
    "providers": {

       pc1/pc2 省略

      "lmstudio-pc3": {
        "api": "openai-completions",
        "apiKey": "lmstudio",
        "baseUrl": "http://192.168.0.103:1234/v1",     画像認識  VLM PC  URL
        "models": [
          {
            "contextWindow": 16384,
            "cost": { "cacheRead": 0, "cacheWrite": 0, "input": 0, "output": 0 },
            "id": "qwen/qwen3-vl-4b",
            "input": [ "text", "image" ],
            "maxTokens": 16384,
            "name": "qwen/qwen3-vl-4b",
            "reasoning": true
          }
        ]
      },
    }
  },
  
}

テキスト埋め込みモデルの指定

OpenClaw で Local LLM を使う場合は、メモリ検索用の埋め込みモデルを指定する必要があります。

OpenClaw が走っている PC のスペックが高く、RAM もストレージも余裕がある場合は CPU が使えます。とはいえ 300m (0.3b) でも 1GB ほどメモリを消費しますので、スペックに余裕がない場合はこれまでと同じ様に他の PC を割り当てて使うことが可能です。

Ollama で Local CPU を使う場合の例

  1. Ollama をインストール
  2. モデルをダウンロード
    • ollama pull embeddinggemma:300m
  3. 以下の設定を追加
{
  "agents": {
      "memorySearch": {
        "provider": "openai",
        "model": "embeddinggemma:300m",             埋め込みモデル
        "fallback": "none",
        "remote": {
          "baseUrl": "http://127.0.0.1:11434/v1",   埋め込みモデル用 PC  URL
          "apiKey": "ollama"
        }
      },
      
    }
  },

}

他の PC で処理する場合の例

LMStudio を使って他の PC 上で走らせる場合の設定例。

{
  "agents": {
      "memorySearch": {
        "provider": "openai",
        "model": "text-embedding-qwen3_embedding_4b",    埋め込みモデル
        "fallback": "none",
        "remote": {
          "baseUrl": "http://192.168.2.103:11434/v1",    埋め込みモデル用 PC  URL
          "apiKey": "lmstudio"
        }
      },
      
    }
  },

}

上記以外に provider = “local” を使う方法もあります。以下のページにまとめています。

しばらく使用してみて

llama.cpp のキャッシュ再利用のおかげで思ったよりもレスポンスは早いです。Slack で簡単な応答なら、リアクションマークが付いたあと 10秒くらいでストリーミングが始まります。ストリーミング表示されないクライアントだと全部生成してからメッセージが届くため、体感速度はだいぶ下がると思います。

たまに Heartbeat ジョブが走って Prefill 待ちが入ることがありますが、それでも長くて 2分くらいです。Heartbeat 用 PC があればこの待ち時間がなくなります。

内容も普通にチャットしている分には全く違和感なく、簡単なプログラムの作成なども問題なくこなします。memory も増えて徐々に育てていくことができます。普通に使う分には十分です。700b などの、よりパラメータ数の多いモデルと比べると細かいところでは正確性(追従性)に差が出るようです。メモリ更新などは指示して明示的にやらせた方が良いです。バックアップはこまめに取りましょう。

応答の仕方はモデルによって結構変わります。用途に合わせてモデルや量子化、temperature 等のパラメータ調整をしていくと良いのかもしれません。Sub Agent も当初はタイトル通り Qwen3.5 122B-A10B を使っていたのですが、今は Nemotron 3 Super に置き換えてテストしています。

注意点

OpenClaw で Local LLM を使用する場合はリスクを伴います。必ず完全に隔離した仮想マシンで Sandbox を有効にしてください。また重要な情報は絶対に与えず、テストする場合でもネットワークアクセスを制限しておくことをお勧めします。

{
  "agents": {
    "defaults": {
      "sandbox": {
        "mode": "all"
      },
      
    }
  },
  
}

openclaw status コマンドを実行すると、制限無しに 300b 未満のモデルを使っている場合にセキュリティの警告が表示されます。今回の説明でも 120b のモデルを使っているためセキュリティ警告が出ています。考えられるリスクとして、AI が騙されて危険な指示に従ってしまう可能性があります。OpenClaw ではできるだけ性能が高いモデルの利用が推奨されていますので、Local LLM を使う場合はご注意ください。

関連ページ